別再每天從頭教 Claude 一次:第二大腦資料夾實測(含 gbrain、ai-memory 整理)
先說結論:同一個 Claude,有沒有「讀過你的資料夾」,給你的答案差很多。X 上 @imryven 在 2026 年 11 月 8 日發了一串「YC 執行長把自己的第二大腦開源了,大多數人還不知道」,列出 8 個 second brain 專案,3.5K 人收藏、約 28 萬次觀看(11/18 查看)。這篇我們做三件事:實際跑一次「沒有筆記」和「有筆記」的差別、把串裡的專案逐一讀過 repo 整理給你、再給你一個今天 5 分鐘就能自己做的最小版本。
原串:X @imryven(2026/11/8)。以下 star 數、授權、更新時間,都是 2026/11/18 直接從 GitHub 讀的。
問題:每天都在從頭教 AI 一次
你有沒有這種經驗:開一個新對話,問「幫我排一下今天下午的工作」,AI 很客氣地回你「我看不到你的行事曆,請提供你的待辦清單、時間範圍、固定行程、優先順序」。你把這些再打一遍,它給你一張通用的表。明天你再問一次,它又什麼都不記得。
原因很單純:每一次對話,AI 都是從空白開始。它不知道你是誰、手上有什麼專案、上週已經做過什麼決定。不是它不夠聰明,是你沒有給它任何東西可以讀。
「第二大腦」想解決的就是這件事:把你的背景、專案、決定寫成一份份純文字筆記,放在固定資料夾,讓 Claude 每次開工先讀,再回答。
實測:同一個問題,兩個結果
我們做了一個最小版本。一個資料夾,裡面一個 CLAUDE.md,加一個 notes/ 資料夾,放三份筆記。內容是我們虛構的「小安」:台北一家 12 人記帳 App 新創的 PM(影片和文章裡都標示為示範資料)。
CLAUDE.md 只有兩句:回答前先讀 notes/ 裡的筆記,再回答;用繁體中文、條列、不超過 5 點。
三份筆記:
about-me.md:小安是誰,每週二、四下午開 sprint 會議,週三下午要專心寫 PRD、不接會,討厭長篇大論。projects.md:11/22 要上線「共同帳本」,還有 2 個 bug 沒修;週五(11/20)老闆要看調價簡報初稿;使用者訪談做完 3 場,還差 2 場。decisions.md:調價方案只調年訂閱、月訂閱不動;共同帳本上線先不做推播通知。
然後對 Claude Code(用 claude -p 在終端機實際執行)問同一句:「幫我排一下今天下午的工作。」
沒有筆記的資料夾: 它回的是「好的!不過我看不到你的行事曆或待辦清單,需要你提供一些資訊」,列出 4 個要你補的問題,最後附一張通用的下午時間表(處理信件、專注時段、休息、開會、雜事)。每個人問都會拿到一樣的東西。
有筆記的資料夾: 它直接回:
- 今天是週三,下午照慣例不接會;最急的是週五要交老闆的調價簡報初稿,所以先做這個。
- 13:30–15:30 調價簡報初稿,照已定案的方向寫:只調年訂閱,月訂閱不動。
- 15:30–16:30 寫 PRD,保留週三固定寫 PRD 的時間。
- 16:30–17:00 用訊息問工程那 2 個 bug 什麼時候修好,不開會;推播通知已決定留到下一版,不用討論。
- 17:00–17:30 約剩下 2 場使用者訪談,排在週四 sprint 會議以外的時段,並提醒它沒看行事曆,有衝突要說。
差別不是 Claude 變聰明了,是它讀到了「週三不接會」「只調年訂閱」「還有 2 個 bug」。這三件事,你每次都要重講一遍;放進資料夾之後,只寫一次。
說明:兩次都是真的跑出來的(Claude Code 實跑,時間 2026/11/18),回答文字有節錄;不同時間跑措辭會不同,但「一個先問你、一個直接排」的方向穩定。影片和這裡的筆記內容都是為示範虛構的,不是任何人的真實資料。
自己做:5 分鐘最小版本
- 建一個資料夾,例如
~/my-brain。 - 在裡面建
CLAUDE.md,寫:「回答前先讀 notes/ 裡的筆記。用繁體中文。」 - 建
notes/,先放三份:about-me.md(你是誰、工作習慣、不接會的時段)、projects.md(進行中的事和期限)、decisions.md(已經決定、不要再提的事)。 - 之後在這個資料夾裡開 Claude Code,直接問問題。
三個小建議:
- 筆記寫「事實和決定」,不要寫長文。每份控制在幾十行,Claude 才會真的讀完。
decisions.md最有用:它擋掉的是「AI 又提了你早就否決的方案」。- 不要放密碼、金鑰、客戶個資。這是純文字檔,會被讀進對話。
串裡的專案:我們讀了什麼
下面這些是 @imryven 串裡的專案,我們逐一看過 repo 的說明。我們沒有全部安裝實測,只實測了上面的最小版本。
gbrain(garrytan/gbrain)
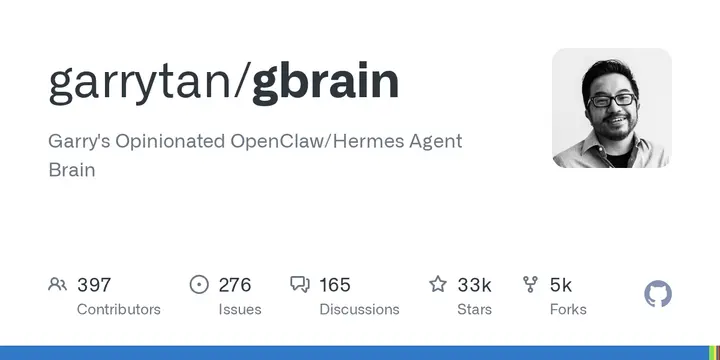
貼文說它是 Y Combinator 執行長 Garry Tan 的第二大腦。repo 說明寫「Garry's Opinionated OpenClaw/Hermes Agent Brain」,MIT 授權,約 3.3 萬顆星,11/18 當天還有更新。README 的定位是:「一個給你和公司用、每個 agent 都會讀的大腦」,你把筆記、決策紀錄、通話逐字稿放在一起,Claude Code、Codex 等 agent 在回答前會先去那裡找。
安裝要注意:README 明講它不是發佈在 npm,npm 上同名的 gbrain 是別的套件,不要用 npm install -g gbrain;要用 bun install -g github:garrytan/gbrain#stable,需要 Bun 1.4.4 以上。接 Claude Code 是 gbrain setup claude-code。另外有付費的託管版 gbrain.io,自架是免費的、一開始不需要任何 API key(用關鍵字搜尋,之後可以加)。
ai-memory(akitaonrails/ai-memory)
約 1.6 萬顆星,MIT。重點是「換工具不失憶」:記憶放在純 markdown,Claude Code 做到一半換 Codex 接手,不用重新交代。適合已經同時用好幾個 coding agent 的人。
open-second-brain(itechmeat/open-second-brain)
約 600 顆星,MIT,記憶放在你的 Obsidian vault。亮點是「每晚的整理」:把你一再重複糾正的事,變成已確認的偏好(repo 說明稱 dream pass)。它原本是為 Hermes Agent 做的,有給 Claude Code 等工具的 adapter。星數還小,採用前先看 issue 和更新頻率。
claude-second-brain(jessepinkman9900/claude-second-brain)
約 170 顆星,MIT。一行 npx claude-second-brain 幫你建好 Obsidian vault、Claude Code 設定和本機搜尋(qmd),並用 GitHub 備份。靈感來自 Karpathy 的「給 LLM 一份 idea file,讓它維護知識庫」。最後更新是 2026 年 4 月,適合當範本看,長期使用前先確認是否還在維護。
其他
串裡還有 COG second brain(35 個 skill、10 個 agent,約 1.5K 顆星)等;想了解全貌可以直接看原串。
該選哪個?
- 只想先試試看:用上面的 5 分鐘最小版本,不裝任何東西。
- 同時用多個 coding agent:看 ai-memory 或 gbrain。
- 本來就用 Obsidian:claude-second-brain 或 open-second-brain。
- 團隊要共用:gbrain 的定位是「你和公司」,但設定較重,先在個人電腦試完再決定。
風險和限制
- 筆記越多,每次對話讀的內容越多,回應可能變慢、花更多額度。先從幾份短筆記開始。
- 這些 repo 都在快速變動,安裝指令以各自 README 為準。
- 記憶檔會被讀進對話,敏感資料不要放。
- 我們的實測只有一個題目,不代表每種問題都會變好;它對「需要知道你的狀況」的問題最有感,對一般知識問答差別不大。
留言「記憶」
我們把這篇用到的 3 個 repo 連結和 5 分鐘版資料夾範本(CLAUDE.md 加三份筆記)整理好了。在 Instagram 留言「記憶」,會私訊給你。追蹤 @your.engineer.ben,看更多 AI 用法。
參考來源:x.com